实战:继续读反汇编
继续读反汇编
接下来看点比较深入的,指针和数组怎么样?
这是简单的一个指针示例代码
c
int main()
{
    int x = 100;
    int *p = &x;

    *p = 200;

    return 0;
}
我们来看看反汇编是什么样的
asm
mov dword ptr ss:[rbp-C],64
lea rax,qword ptr ss:[rbp-C]
mov qword ptr ss:[rbp-8],rax
mov rax,qword ptr ss:[rbp-8]
mov dword ptr ds:[rax],C8
mov eax,0
add rsp,30
pop rbp
ret
首先我们发现依然是经典的赋值,然后操作,先是赋值:
asm
mov dword ptr ss:[rbp-C],64
lea rax,qword ptr ss:[rbp-C]
mov qword ptr ss:[rbp-8],rax
这里有点奇怪,编译器给这个指针预留了8字节的空间,然后先把常数64放进去,然后再计算这个位置的地址,再放入预留好的位置,这里顺序又和我们之前看的不太一样,不过不管了,能看懂就行
接着就是一个简单的赋值操作:
asm
mov rax,qword ptr ss:[rbp-8]
mov dword ptr ds:[rax],C8
把地址从栈空间取出来给rax,然后把rax作为地址,把C8存进rax指向的空间
指针作为函数参数
依旧使用示例代码,这次我们用函数来操作变量
c
void change(int *p)
{
    *p = 200;
}

int main()
{
  	printf("yulabu");
    int x = 100;

    change(&x);

    return 0;
}
我们又得到了反汇编代码:
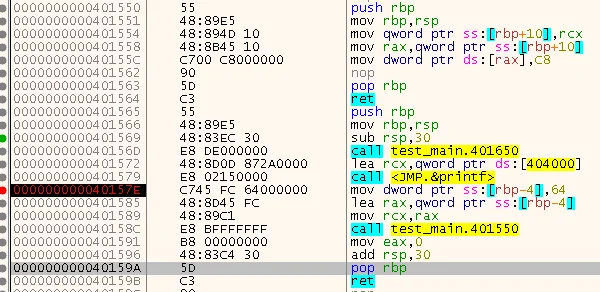
随手拆分一下:
-
change函数部分
asmpush rbp mov rbp,rsp mov qword ptr ss:[rbp+10],rcx mov rax,qword ptr ss:[rbp+10] mov dword ptr ds:[rax],C8 nop pop rbp ret -
main函数部分,前面的printf相关的我们先不看,只关注后面的指针处理:
asm
mov dword ptr ss:[rbp-4],64
lea rax,qword ptr ss:[rbp-4]
mov rcx,rax
call test_main.401550 # 跳转到change
mov eax,0
add rsp,30
pop rbp
ret
我们发现,常数64入栈后,因为change函数传入的参数是个地址,所以在call之前先把传入的x处理一下,用lea计算地址,然后放入rcx传入函数
然后我们可以看到,change函数里面对rcx的操作和之前的指针操作差不多,函数执行完之后,地址为rax的数值被更改了
这其实就是我们一开始学c语言遇到的小问题:C 语言函数参数默认是值传递,直接修改形参只会修改副本;想在函数内部修改函数外的变量,需要传入变量的地址,通过指针间接修改
数组在反汇编
之前我们搞了指针,现在回忆下数组,好像就是有一个数组名+数组索引来获取对应值,这和我们rsp和rbp的原理很像呢
我们用以下示例代码:
c
#include<stdio.h>
int main()
{
		printf("yulabu");
    int arr[3] = {10, 20, 30};
    int *p = arr;

    int x = p[1];
    int y = arr[1];

    return 0;
}
这学起来真的很神圣😇,跟复习大一c语言一样,我们把汇编分成几个部分:
这是初始化数组:
asm
mov dword ptr ss:[rbp-1C],A
mov dword ptr ss:[rbp-18],14
mov dword ptr ss:[rbp-14],1E
lea rax,qword ptr ss:[rbp-1C]
mov qword ptr ss:[rbp-8],rax我们可以看到这一个个数值被存到局部变量空间,然后计算第一个数值的地址作为首地址,放入rax然后压入局部变量空间,
然后我们进行了一些操作,首先是首地址被取出来赋值给*p:
asm
mov rax,qword ptr ss:[rbp-8]诶,接下来怎么用eax了,怎么降到32位了,我们看看哈,其实也没什么,地址和int装的寄存器能一样吗,rax装的不是首地址嘛,然后我们的p[1]就是相对首地址偏移一个数值(四个字节),拿出来给eax,然后压入栈
asm
mov eax,dword ptr ds:[rax+4]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-18]
mov dword ptr ss:[rbp-10],eax
这里的p[1]和arr[1]的首地址取出好像有些区别:
- 用存首地址的指针取出数据,就用寄存器
- 但是直接用数组名的话,编译器自动计算偏移数,直接在局部变量空间找到对应数据
这个区别能说明什么呢?我也不知道,不管了能看得懂就行(
字符串在汇编
字符串本质也是数组,虽然但是,我们之前可以用搜索直接找出字符串啊,我还没试过用这个功能找数组呢,难道有区别吗?让我们来试试
c
int main()
{
    char str[] = "yulabu";
    char *p = str;

    char c = p[1];

    return 0;
}然后我就尝试了一下,诶,这样初始化的一个字符串在搜索功能里找不到喵!难道说编译器对他们的类型有区分?好吧我还是老老实实加个printf来定位,最后得到如下反汇编:
asm
mov dword ptr ss:[rbp-10],616C7579
mov word ptr ss:[rbp-C],7562
mov byte ptr ss:[rbp-A],0
lea rax,qword ptr ss:[rbp-10]
mov qword ptr ss:[rbp-8],rax
mov rax,qword ptr ss:[rbp-8]
movzx eax,byte ptr ds:[rax+1]
mov byte ptr ss:[rbp-9],alwoc,什么玩意,这还是国内吗好的,经过与神的沟通,我想我大概搞明白了
我可能在之前提到过x86是小端模式?不管了,小端序其实就是低地址存低位字节,高地址存高位字节,然后这样机器读着很爽,但是人读着不爽,大端模式就是反过来,人读着很爽(因为是从左到右),但是机器读着麻烦
所以实际上字符串的赋值其实在前两行:
asm
mov dword ptr ss:[rbp-10],616C7579
mov word ptr ss:[rbp-C],7562
赋值的字节这样拆分:
61 6C 75 79由于是小端模式,我们从左往右读,根据ascii表可以得到四个字母:yula
这是小端模式写法,如果是大端模式:
79 75 6C 61这样从左往右读就是yula
第二行也是一样的效果,然后我们能在内存窗口看到这样的效果:

这个内存窗口为了方便我们阅读,用的就是大端模式
asm
mov byte ptr ss:[rbp-A],0这是在末尾补了\0,这是字符串会干的是,我就不管为什么了,继续(
asm
lea rax,qword ptr ss:[rbp-10]
mov qword ptr ss:[rbp-8],rax
然后就正常把首地址放到局部变量空间,也很简单,最后一步就看这个字符串的内容如何以数组的形式访问
asm
mov rax,qword ptr ss:[rbp-8]
movzx eax,byte ptr ds:[rax+1]
mov byte ptr ss:[rbp-9],al
movzx是从内存读取一个较小的数据,放进更大的寄存器,高位补 0,常用:
asm
movzx eax, byte ptr [...]我们这里就是这样用的,后面可能还有movsx是符号扩展
最后一步就是把p[1]读取出来了,这里al其实是ax的低位,搭配前面的byte,其实就是拿al的最低字节进eax
二维数组在反汇编
这感觉会很疯狂,我们用以下示例代码:
c
#include<stdio.h>
int main()
{
  	printf("yulabu");
    int arr[2][3] = {
        {10, 20, 30},
        {40, 50, 60}
    };

    int x = arr[1][2];

    return 0;
}
依旧看看反汇编:
asm
mov dword ptr ss:[rbp-20],A
mov dword ptr ss:[rbp-1C],14
mov dword ptr ss:[rbp-18],1E
mov dword ptr ss:[rbp-14],28
mov dword ptr ss:[rbp-10],32
mov dword ptr ss:[rbp-C],3C
这六个不出意外就是存的数组了,下面两行就是编译器自己计算出位置在哪,直接拿出来了(
asm
mov eax,dword ptr ss:[rbp-C]
mov dword ptr ss:[rbp-4],eax
也没啥不一样的,就编译器自己记位置了,不过这个数组要是大了,我不敢想我看起来得多难受(
结构体在反汇编
c
#include<stdio.h>
struct Player
{
    int hp;
    int level;
    int score;
};

int main()
{
  	printf("yulabu");

    struct Player p;

    p.hp = 100;
    p.level = 10;
    p.score = 999;

    int x = p.score;

    return 0;
}
感觉反汇编有点简单啊:
asm
mov dword ptr ss:[rbp-10],64
mov dword ptr ss:[rbp-C],A
mov dword ptr ss:[rbp-8],3E7
mov eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-4],eax
不对,你怎么把我的结构体优化了,坏编译器(
那我们只能跟数组一样的理解了,本来理论上应该是有个寄存器存这个结构体的首地址,然后根据这个寄存器的偏移来找他的成员的(
不过这样也差不多,就先这样吧
堆内存在反汇编
这个有点神圣了,堆是堆,栈是栈,堆栈是栈,也不知道怎么划分堆区的,我们来看看吧
c
#include <stdlib.h>
#include <stdio.h>
int main()
{
  	printf("yulabu");

    int *p = malloc(sizeof(int));

    *p = 100;

    int x = *p;

    free(p);

    return 0;
}
反汇编:
asm
mov ecx,4
call <JMP.&malloc>
mov qword ptr ss:[rbp-8],rax
mov rax,qword ptr ss:[rbp-8]
mov dword ptr ds:[rax],64
mov rax,qword ptr ss:[rbp-8]
mov eax,dword ptr ds:[rax]
mov dword ptr ss:[rbp-C],eax
mov rax,qword ptr ss:[rbp-8]
mov rcx,rax
call <JMP.&free>
malloc和free是库函数,就不当啥子进去看看了,当黑盒用就好了,让我们来拆解一下:
asm
mov ecx,4
call <JMP.&malloc>
mov qword ptr ss:[rbp-8],rax
mov rax,qword ptr ss:[rbp-8]
根据源代码推测,这个rax存的应该就是malloc处理完后提供的地址,至于前面的ecx应该是算的int的大小,然后直接传入给malloc用,最后结果到rax,放到局部变量空间(*p)
asm
mov dword ptr ds:[rax],64然后往这个地址的空间存入64h
asm
mov rax,qword ptr ss:[rbp-8]
mov eax,dword ptr ds:[rax]
mov dword ptr ss:[rbp-C],eax
给变量x赋值,然后放入局部变量空间
asm
mov rax,qword ptr ss:[rbp-8]
mov rcx,rax
call <JMP.&free>这一步应该是把存在局部变量空间的堆空间地址取出来,然后放入rcx给free作为参数用,释放堆空间
函数指针在反汇编
这个用法很神圣啊,我自己都没用过这东西,就用这个来收尾吧
c
#include<stdio.h>
int add(int a, int b)
{
    return a + b;
}

int main()
{
  	printf("yulabu");
    int (*p)(int, int) = add;

    int x = p(10, 20);

    return 0;
}
反汇编如下:
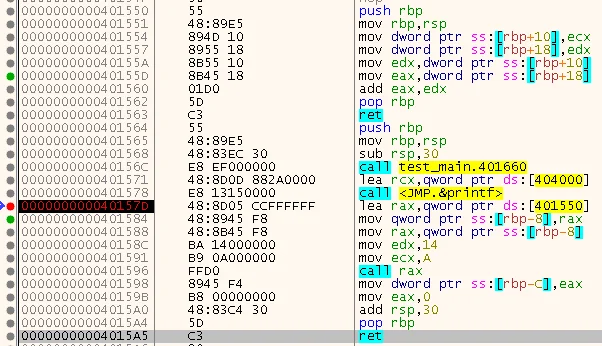
让我们来分析下:
-
add函数:
asmpush rbp mov rbp,rsp mov dword ptr ss:[rbp+10],ecx mov dword ptr ss:[rbp+18],edx mov edx,dword ptr ss:[rbp+10] mov eax,dword ptr ss:[rbp+18] add eax,edx pop rbp ret -
main函数(去掉定位的printf):
asmlea rax,qword ptr ds:[401550] mov qword ptr ss:[rbp-8],rax mov rax,qword ptr ss:[rbp-8] mov edx,14 mov ecx,A call rax mov dword ptr ss:[rbp-C],eax
让我们来解析下main函数先:
asm
lea rax,qword ptr ds:[401550]
mov qword ptr ss:[rbp-8],rax首先这个就是简单的计算我们add函数所在位置的地址,然后存进局部变量空间
asm
mov rax,qword ptr ss:[rbp-8]
mov edx,14
mov ecx,A
call rax
把函数的地址取出来,初始化参数,然后edx和ecx传入rax指向的函数
asm
mov dword ptr ss:[rbp-C],eax最后一步收尾就是把返回到eax的数据移入局部变量空间,至于add函数很简单,就不多赘述了
评论