实战:初读反汇编
实战:初读反汇编
先大概整理下我现在要熟悉的指令
-
mov:数据搬运
-
lea:计算数据有效地址并存储到寄存器中;但是也可以用来计算,如
lea eax, [ecx + ecx*2],这里是把右式计算后传给eax,不是算地址 -
add、sub、imul有符号乘法(常用于数组方案)
-
xor按位异或,常见
xor edx, edx的意思就是清零edx,edx = edx ^ edx -
and按位与,如:
and eax, ebx的意思就是:eax = eax & ebx,常用于判断奇偶 -
or按位或,如:
or eax, ebx的意思就是:eax = eax | ebx -
shl逻辑左移,shr逻辑右移(补0)
-
sal算数左移,sar算数右移(左边补符号位,左移和shl没区别,x86统一用shl)
-
cmp比较:常与如下指令配合
asm 复制代码je jne jg jl jge jle -
test位测试/设置标志
-
jmp无条件跳转
-
je(jump if equal)相等就跳转,常与cmp共同出现
-
jne(jump if not equal)不相等就跳转
-
jg(jump if greater)大于就跳转,
cmp eax, 10可以看作if eax > 10 -
Jl(jump if less)小于就跳转,反过来
-
jle和jge也是差不多,大于等于和小于等于
-
同时还有区分有符号和没符号
复制代码jg / jl / jge / jle 有符号 ja / jb / jae / jbe 无符号 -
call调用函数,配套的还有ret
-
push压栈/pop出栈
大概就这些,那么我们来实战吧
先解决一下之前看不懂的指令(
首先搞懂一个困扰我挺久的变量(就当这东西是变量吧),反汇编里会这么写
asm
复制代码
mov rax, qword ptr ds:[4042E0]这什么雷霆,前面的指令我能看懂,后面的一串是啥?
先说第一个,本质上是在说明要操作多大的数据:
- byte:1字节,8bit
- word:2字节,16bit
- dword(double word):4字节,32bit
- qword(quad word):8字节,64bit
- tword(
然后就是第二个,ptr->pointer,前面的byte等说明就是要告诉ptr要取多大的数据,ptr是用来明确操作大小的
至于第三个,ds几乎可以忽略,只看后面的地址就好理解了,带了个[]的基本就是要取里面的地址指向的数据
如果换成lea呢
asm
复制代码
lea rax, qword ptr ds:[4042E0]我们知道lea是用来计算地址的,所以[4042E0]算完就是4042E0
初步熟悉c代码在汇编中的表示
c
复制代码
#include <stdio.h>
int main()
{
    printf("test");
    int a = 1;
    int b = 2;
    int c = a + b;
    char ch = '1';
    float f = 1;
    double d = 1;
    long double ld = 1;
    long long ll = 1;
    return 0;
}
我们用打印来定位主函数的位置,然后我们来观察下不同的数据类型在汇编中如何存储
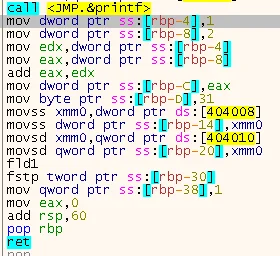
有点神圣啊,怎么又多了这么多指令,诶,好像多的也不多
- movss:移动一个 32 位单精度浮点数
- movsd:移动一个 64 位双精度浮点数
double - fld1:把浮点数
1.0压入 x87 浮点栈(不用细究) - fstp:可以理解成把浮点栈中的值弹出来到内存地址
这下应该没有看不懂的了(
我们可以看到,最简单的a+b
c
复制代码
int a = 1;
int b = 2;
int c = a + b;
在汇编中的操作是;
asm
复制代码
mov dword ptr ss:[rbp-4],1
mov dword ptr ss:[rbp-8],2
mov edx,dword ptr ss:[rbp-4]
mov eax,dword ptr ss:[rbp-8]
add eax,edx
mov dword ptr ss:[rbp-C],eax 我们会发现,简单的把常数1和2先放在栈帧提前划分好的局部变量空间里面:这其实是给栈上的一个局部变量赋值
然后在让我们的寄存器从栈空间中取出,执行add,然后再放回局部变量空间中
我们会发现放的位置又不同了,其实这个局部变量就是放在第三个槽位,即我们在c代码中写的变量c
理解完完整的加法操作,我们再来大概看一下其他数据类型是怎么赋值的:
c
复制代码
char ch = '1';这个我们发现非常简单啊
asm
复制代码
mov byte ptr ss:[rbp-D],31根据ASCII表,31号确实就是符号1,这里将这个常数以一字节的大小放入预留的栈空间
而且很有意思的一点就是:这里相对rbp的位置跟前面的int比起来就移了一位,和这个一字节对应上了
c
复制代码
float f = 1;老实说 这个float之前已经演示过了:
asm
复制代码
movss xmm0,dword ptr ds:[404008]
movss dword ptr ss:[rbp-14],xmm0就是用专属寄存器xmm0来存,至于为什么是从这个404008的位置取出来,我猜测应该是在编译的时候放在那了,估计是个放数据的区域,之前的字符串也是放在这种40开头的位置,然后进7位放在局部变量空间(应该是编译的时候考虑了对齐),这里dword已经说明这个数据就占4字节
c
复制代码
double d = 1;这个double也没啥好说的,也是浮点数,也用xmm0,但是用的qword和movsd,也就是说精度到了64位,占8个字节
asm
复制代码
movsd xmm0,qword ptr ds:[404010]
movsd qword ptr ss:[rbp-20],xmm0
但是进了12位是为啥,我服了,我学个汇编容易吗,唉,编译器爱咋地咋地吧,应该是自己预留4个字节的padding了
c
复制代码
long double ld = 1;
long long ll = 1;
后面的long double就更离谱了
asm
复制代码
fld1
fstp tword ptr ss:[rbp-30]
mov qword ptr ss:[rbp-38],1
不过也还算好理解,前面的fld自己压入了自己的栈,我就不管了,后面fstp就把这个值弹出来给当前局部变量空间(又吃16字节)
long long就正常留了8个字节的空间
算数运算在反汇编
我们使用以下的c语言代码
c
复制代码
#include <stdio.h>
int main()
{
    printf("test");
    int a = 6;
    int b = 3;
    int c;
    c = a + b;
    c = a - b;
    c = a * b;
    c = a / b;
    c = a % b;
    return 0;
}
编译后进入反汇编,我们找到以下指令
asm
复制代码
mov dword ptr ss:[rbp-4],6
mov dword ptr ss:[rbp-8],3
mov edx,dword ptr ss:[rbp-4]
mov eax,dword ptr ss:[rbp-8]
add eax,edx
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
sub eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
imul eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
cdq
idiv dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
cdq
idiv dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],edx
mov eax,0
add rsp,30
pop rbp
ret
我们继续一步步分析吧,加法没什么好说的,之前演示过了,我们看看加法后怎么处理减法的
asm
复制代码
mov dword ptr ss:[rbp-4],6
mov dword ptr ss:[rbp-8],3
mov edx,dword ptr ss:[rbp-4]
mov eax,dword ptr ss:[rbp-8]
add eax,edx
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
sub eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
前四行代码把我的常量6、3压入局部变量空间,然后从栈中取出给寄存器,执行add,结果在eax
接下来的指令就先把计算结果压入栈,然后寄存器重新取出局部变量
asm
复制代码
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
sub eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
做减法,计算结果继续压入栈,然后看看乘法
c
复制代码
c = a * b;好像挺简单的
asm
复制代码
mov eax,dword ptr ss:[rbp-4]
imul eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
将变量a的数据取出来继续算,因为这里用的是同一个变量c来存,所以计算结果入栈的时候把之前的计算结果覆盖了
接着是除法:
c
复制代码
c = a / b;等下,我刚夸你简单来着,怎么又背刺我
asm
复制代码
cdq
idiv dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]这个cdq是什么鬼这个cdq还有一个长得很像的兄弟cqo,这俩哥们都是专门给除法做准备的,而且非常神秘(
cdq:把 EAX 的符号位扩展到 EDX:EAXcqo:把 RAX 的符号位扩展到 RDX:RAX
还是好神秘,不懂是什么意思,这里的意思就是说,被除数不是单独一个寄存器存放:
以cdq为例,这里的被除数存在两个寄存器里面,从32为提升到64位,其中EDX存高32位的数据,EAX存低32位的数据
除法计算完之后,得到的结果这样保存
复制代码
EAX = 商
EDX = 余数
那就好理解的,等下,好理解在哪(
为啥idiv只有一个操作数啊,不兑,哦我懂了
cdq和idiv的关系就和cmp与je很像,差不多强行绑定的,cdq这一步实际上就是告诉下面的idiv:被除数是EDX:EAX,接下来接收的是除数
这就能说的通了,因为这波做的是整除,所以是eax的数据被压入栈了,最后恢复变量a
asm
复制代码
cdq
idiv dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],edx
至于取余,那就是留edx的数据啦,后面就都是很经典的收尾工作了
位运算在反汇编
我们用以下示例代码
c
复制代码
    #include <stdio.h>
    int main()
    {
        printf("yulabu");
        int a = 12;
        int b = 10;
        int c;
        c = a & b;
        c = a | b;
        c = a ^ b;
        c = a << 2;
        c = a >> 1;
        return 0;
    }
大概常用的就这些位运算吧,反汇编大概长这样
asm
复制代码
mov dword ptr ss:[rbp-4],C
mov dword ptr ss:[rbp-8],A
mov eax,dword ptr ss:[rbp-4]
and eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
or eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
xor eax,dword ptr ss:[rbp-8]
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
shl eax,2
mov dword ptr ss:[rbp-C],eax
mov eax,dword ptr ss:[rbp-4]
sar eax,1
mov dword ptr ss:[rbp-C],eax
mov eax,0
add rsp,30
pop rbp
ret
哇哦,感觉和前面的没啥区别,下班下班
条件判断在反汇编
先来个简单的if-else
c
复制代码
#include <stdio.h>
int main()
{
    printf("yulabu");
    int judge = 10;
    int ans;
    if(judge == 10){
        ans = 1;
    }else{
        ans = 0;
    }
    return 0;
}
编译,然后反汇编一下,得到以下代码:这次有跳转地址,不得不截图
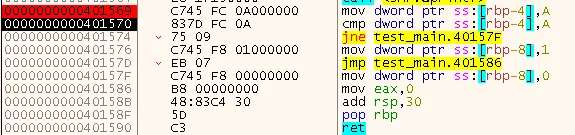
这还是很简单的:10压入局部变量空间,然后用这个局部变量和10对比(好唐的代码)
jne:如果比较结果为不相等,就跳转到我们这个模块的40157F位置,就相当于跳转到:
asm
复制代码
mov dword ptr ss:[rbp-8],0就是我们的ans=0
实际上是相等的,所以这个跳转不会执行,而是继续往下执行:
asm
复制代码
mov dword ptr ss:[rbp-8],1就是我们的ans=1
然后无条件跳转到401586:实际上就是跳过赋值为0的那段指令,然后开始回收栈帧
那我们来接着看看其他条件判断是怎么搞的
c
复制代码
#include <stdio.h>

int main()
{
    printf("yulabu");
    int a = 10;
    int b = 20;
    int ans;
    if (a == b)ans = 0;
    if (a != b)ans = 1;
    if (a > b)ans = 2;
    if (a < b)ans = 3;
    if (a >= b)ans = 4;
    if (a <= b)ans = 5;
    return 0;
}
得到反汇编;
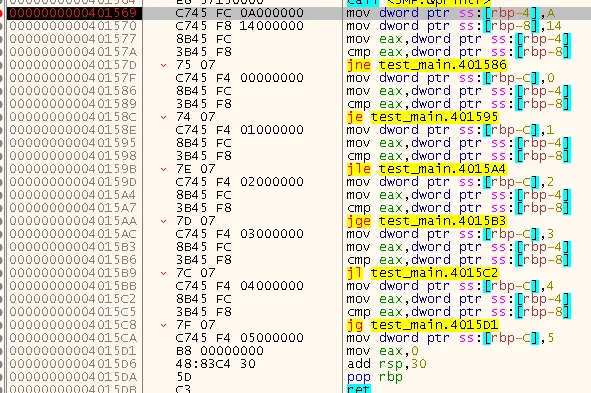
我发现一个规律!汇编里面的条件判断命令和c代码是反过来的!
在c语言中,我们判断的思路是:是否满足条件,满足就执行下面的指令,否则就跳过
在汇编中,判断思路却是:是否不满足条件,不满足就跳过下面的指令,否则继续执行
所以c语言的中==到了汇编就变成jne了!嗯,就这样理解
神秘的test
至今不清楚test有什么用,反汇编我也搞不出来,先留着以后遇到了再记录
循环在反汇编
我们使用以下c语言代码作为示例
c
复制代码
#include <stdio.h>

int main()
{
    int sum = 0;

    for (int i = 0; i < 5; i++)
    {
        sum += i;
    }

    printf("%d\n", sum);

    return 0;
}
这个循环长这样:
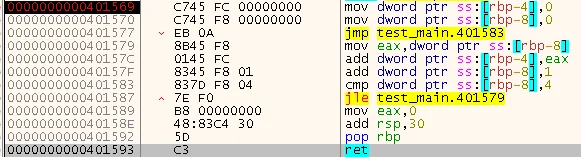
前面的两个初始化应该分别是sum和i,都被赋值为0,然后先跳转到条件判断,看看循环能不能进行:
asm
复制代码
jle test_main.401579依旧和我c语言写的是反过来的,显然现在的i是小于等于4的,所以被跳转去执行循环了(
asm
复制代码
mov eax,dword ptr ss:[rbp-8]
add dword ptr ss:[rbp-4],eax
add dword ptr ss:[rbp-8],1这个循环就是一个简单的加法,运行完再判断,直到i>4,跳转不再执行,就往下走结束函数了
肥肠简单!
switch在反汇编
这个应该跟if差不多吧(大概
c
复制代码
#include <stdio.h>

int main()
{
    int x = 2;
    int result = 0;

    switch (x)
    {
        case 1:
            result = 100;
            break;

        case 2:
            result = 200;
            break;

        case 3:
            result = 300;
            break;

        default:
            result = -1;
            break;
    }

    printf("%d\n", result);

    return 0;
}
然后看看反汇编
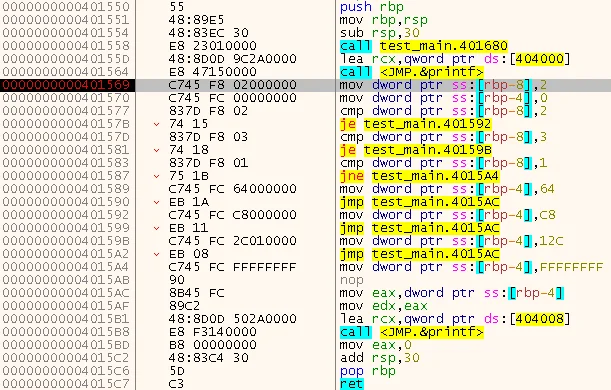
我们会发现这个switch和之前的if不一样,这里排了一堆条件判断和cmp的组合
asm
复制代码
cmp dword ptr ss:[rbp-8],2
je test_main.401592
cmp dword ptr ss:[rbp-8],3
je test_main.40159B
cmp dword ptr ss:[rbp-8],1
jne test_main.4015A4
条件成立就跳转到对应的位置执行指令,不然就继续判断
前面两个还挺正常的,就是比较是不是2或3,是的话就跳转执行下一步指令,不然继续判断
但是最后的1判断有些不一样,可能switch开头第一个条件编译器都会这样特殊处理吧,用的是jne判断,如果是1的话就继续往下执行
asm
复制代码
mov dword ptr ss:[rbp-4],64
jmp test_main.4015AC
然后跳转到4015AC(跟其他两个条件一样的跳转位置2)
如果不等于1,就跳转到5015A4执行:
asm
复制代码
mov dword ptr ss:[rbp-4],FFFFFFFF最后result变成一个神圣的-1,后续就是打印输出的功能了
**如果没有break,或许这个jmp的位置会有所不同?**不管了先这样吧
下一波搞指针吧
评论